How it fits the pipeline
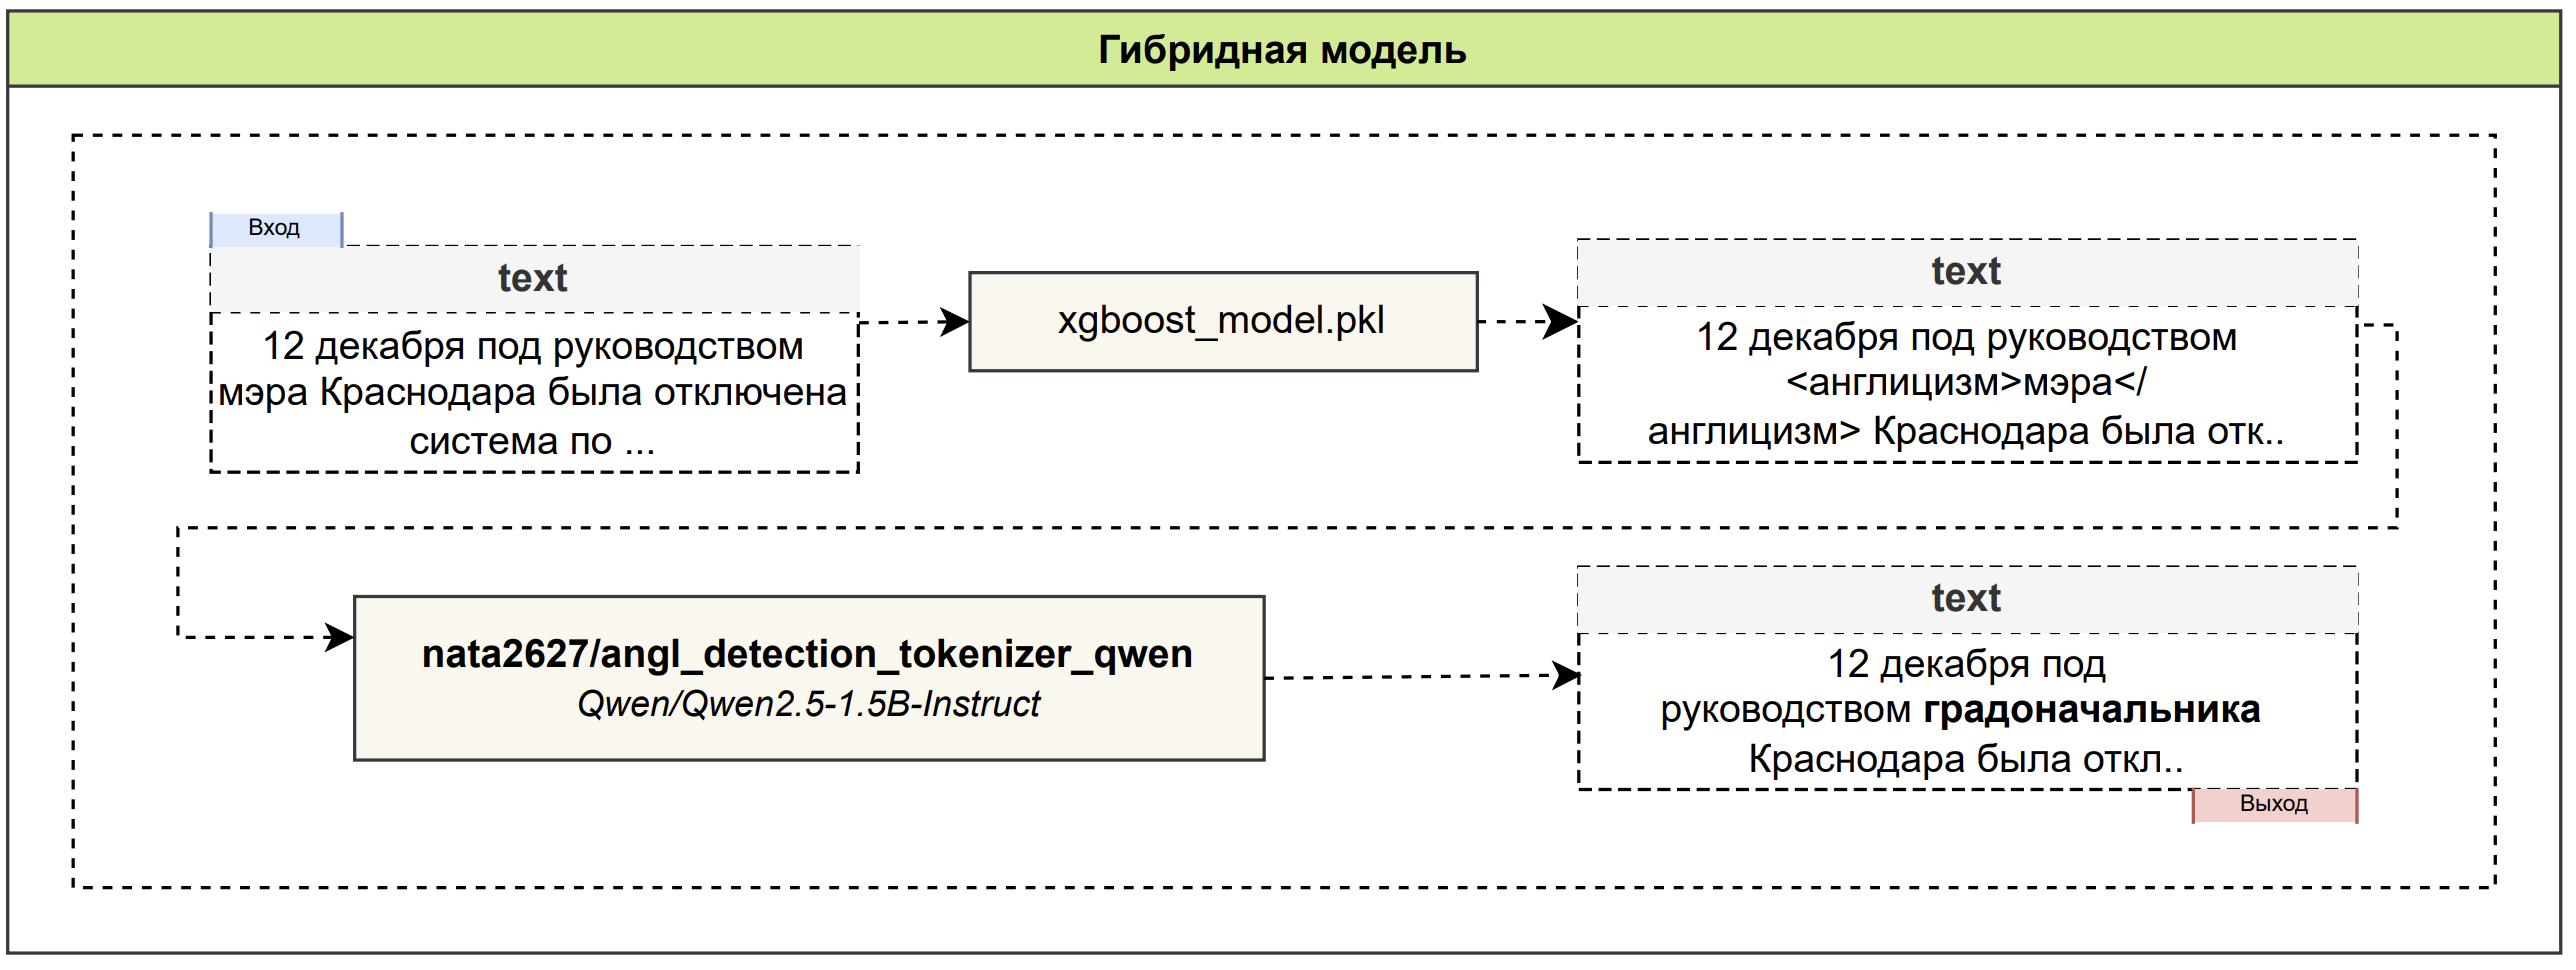
The thesis builds a three-stage hybrid model.
- Detection. XGBoost on morphological and context features finds anglicisms (F1 0.9949, ROC-AUC 0.999 on 10,000 test words).
- Synonyms. Qwen2.5-3B-Instruct proposes Russian equivalents and builds reference sentences.
- Rewriting. This adapter rewrites the whole sentence so that it stays grammatical.
Training
Table | |
|---|
| Base model | TinyLlama/TinyLlama-1.1B-Chat-v1.0 |
| Method | LoRA, r = 16, alpha = 32, dropout 0.05 |
| Target modules | q_proj, k_proj, v_proj, o_proj |
| Special tokens | <англицизм>, </англицизм> added to the tokenizer |
| Data | 18,480 training and 2,310 validation sentence pairs, original and rewritten |
| Training time | 3 h 26 min |
Results
Test sentences against the reference rewrites, as reported in the thesis.
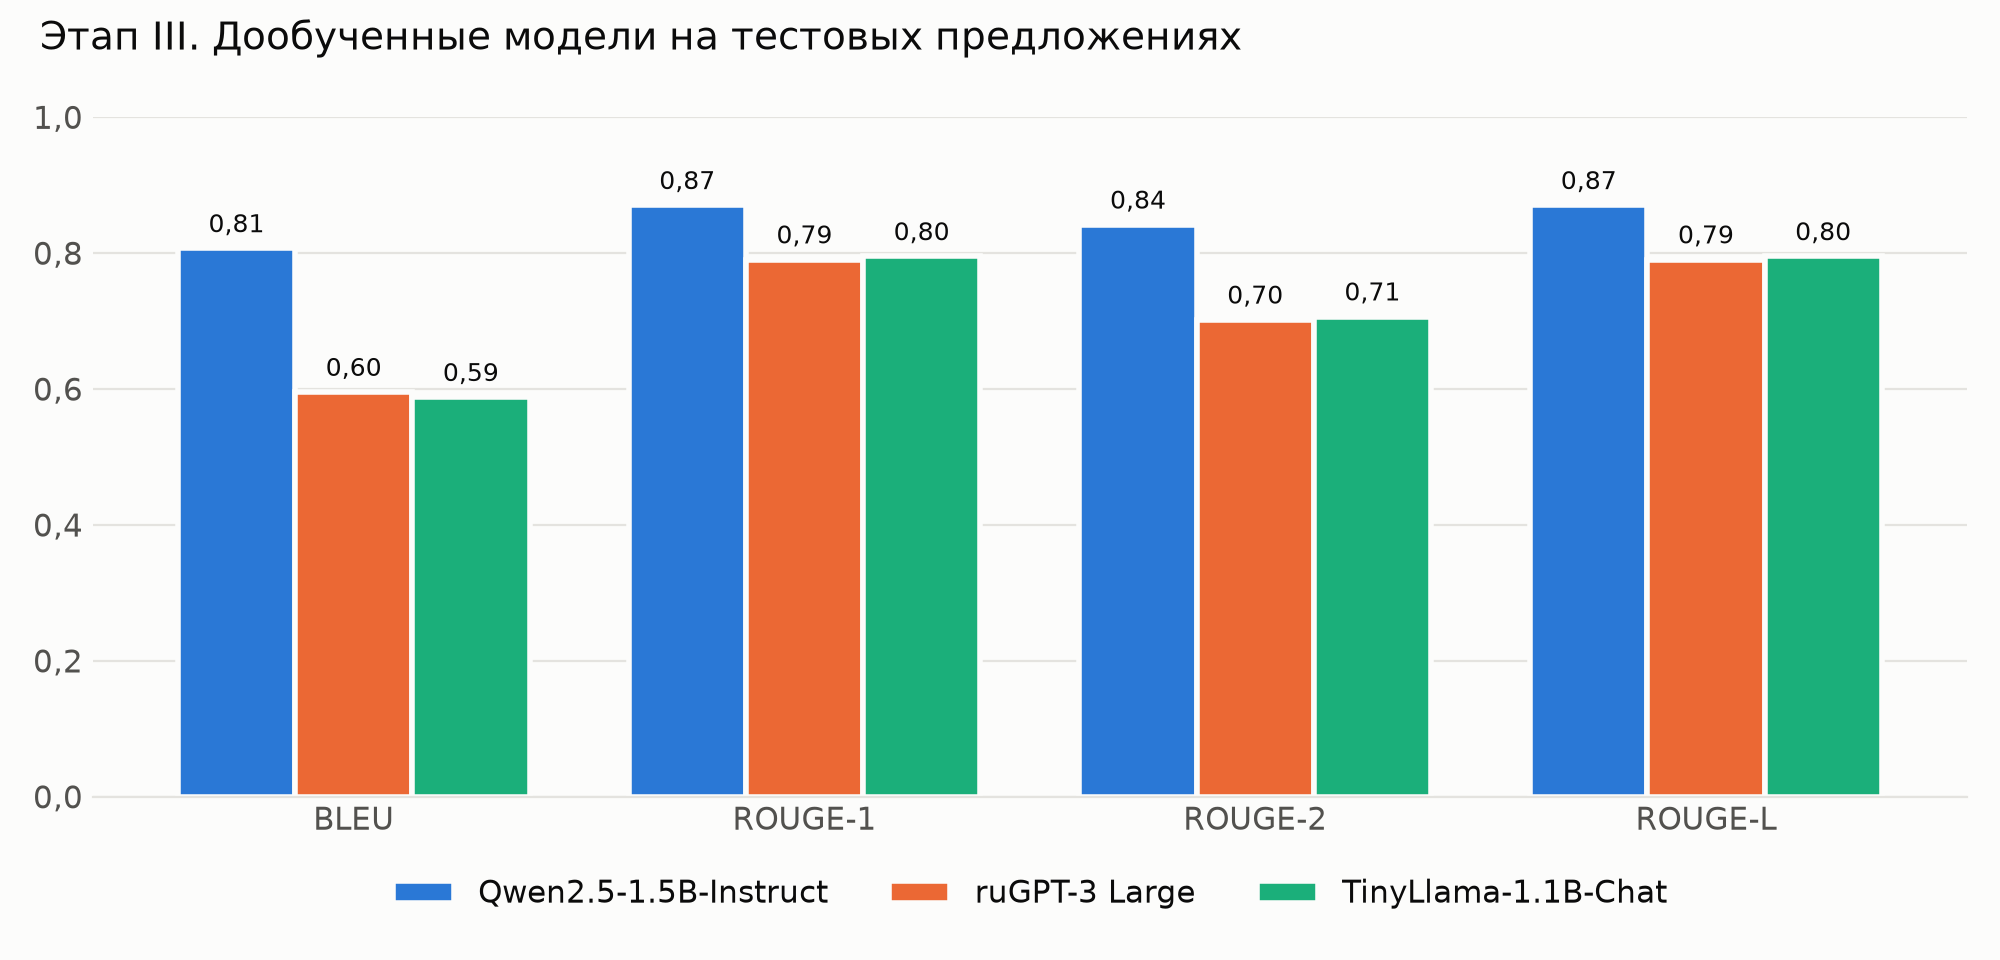
The full hybrid pipeline reaches BLEU 0.805 and ROUGE 0.863 on news sentences against 0.32 and 0.41 for dictionary substitution, and BLEU 0.67 and ROUGE 0.71 on conversational sentences, a text type absent from training.
Usage
The tokenizer in this repository has two extra tokens, so the base model's embeddings have to be resized before the adapter is loaded.
from transformers import AutoTokenizer, AutoModelForCausalLMfrom peft import PeftModel repo = "nata2627/anglicism-rewriter-tinyllama-1.1b-lora"tokenizer = AutoTokenizer.from_pretrained(repo)base = AutoModelForCausalLM.from_pretrained("TinyLlama/TinyLlama-1.1B-Chat-v1.0", torch_dtype="auto")base.resize_token_embeddings(len(tokenizer))model = PeftModel.from_pretrained(base, repo).eval()
The prompt follows the thesis notebook LLM_results/Llama_testing_done.ipynb in the GitHub repository.
Limitations
- The training corpus is RBC news with a strong lean towards politics, quality on other domains and on spoken language is lower.
- The model sometimes produces words that do not exist in Russian. The thesis shows such a case in table 3.2.1.
- The metrics were computed on a small test sample with sampling, so they carry noticeable variance.
- The training data is not published because the RBC terms of use do not allow redistributing its texts.
Русская версия
LoRA-адаптер для TinyLlama/TinyLlama-1.1B-Chat-v1.0, который переписывает русское предложение и заменяет англицизмы русскими аналогами. Обучен для магистерской работы «Применение методов машинного обучения для выявления англицизмов в русскоязычных новостных статьях» (Финансовый университет при Правительстве РФ, 2025). Код и текст работы лежат в anglicism_detection.
Модель для сравнения в дипломе. Лучшая модель лежит в nata2627/anglicism-rewriter-qwen2.5-1.5b-lora.
Место в системе. Гибридная модель из трех этапов. Сначала XGBoost находит англицизмы по морфологическим и контекстным признакам (F1 0,9949, ROC-AUC 0,999 на 10 000 тестовых слов). Потом Qwen2.5-3B-Instruct подбирает русские аналоги и строит эталонные предложения. На последнем этапе этот адаптер переписывает предложение целиком и сохраняет грамматику.
Обучение. LoRA, r = 16, alpha = 32, dropout 0,05, модули q_proj, k_proj, v_proj, o_proj. В токенизатор добавлены <англицизм> и </англицизм>. 18 480 обучающих и 2 310 валидационных пар предложений. Время обучения 3 ч 26 мин.
Результаты на тестовых предложениях по данным диплома.
Гибридная модель целиком дает BLEU 0,805 и ROUGE 0,863 на новостях против 0,32 и 0,41 у словарной замены, а на разговорных фразах, которых не было в обучении, BLEU 0,67 и ROUGE 0,71.
Ограничения. Корпус состоит из новостей РБК с перекосом в политику, на других темах и разговорной речи качество ниже. Модель иногда придумывает несуществующие слова, такой пример есть в таблице 3.2.1 диплома. Метрики посчитаны на небольшой тестовой выборке с сэмплированием, поэтому заметно шумят. Обучающие данные не выкладываются, условия использования РБК не разрешают распространять его тексты.
Citation
Гордеева Н. Г. Применение методов машинного обучения для выявления англицизмовв русскоязычных новостных статьях. Выпускная квалификационная работа магистра.Финансовый университет при Правительстве РФ, 2025.
